Claude Opus 4.6 全面测评:功能、成本与深度集成,它如何塑造下一代企业AI? 本文是Claude Opus 4.6模型的深度测评报告。报告严格遵循十大评估维度,涵盖理解生成能力、智能助手场景、性能指标、安全保护、成本效益与可扩展性,并提供详尽的API调用配置流程。报告指出,该模... AI模型测评库 9个月前04240
视觉觉醒:通义千问VL Plus全面测评报告——多模态能力与成本效益的完美平衡 本文深入测评通义千问VL Plus多模态大模型,从理解能力、生成能力、知识检索、智能助手、性能指标、集成兼容、安全保护、成本效益、可扩展性及本地化部署十大维度展开分析。通过真实场景测试与最新数据,揭示... AI模型测评库 8个月前04170
GLM 4.5 X 深度测评报告:国产大模型的突围与挑战 在国产大模型快速迭代的背景下,GLM 4.5 X作为智谱AI最新推出的旗舰模型,以其"All-in-One"的设计理念引发行业关注。本测评将从技术实现、应用表现和商业价值三个维度,对这款宣称"参数量级... AI模型测评库 1年前04150
LLaVA-OneVision-1.5全面测评:开源多模态模型突破,80亿参数超越商业模型 LLaVA-OneVision-1.5开源多模态模型重磅发布!80亿参数在多项基准测试中超越商业模型,训练成本仅1.6万美元。支持图像、视频、文档多模态理解,提供完整本地部署方案,实测性能卓越,为企业... AI模型测评库 1年前04140
Wan2.2 深度测评:电影级视频生成模型的突破与挑战 在影视创作领域,国产模型Wan2.2正带来全新可能。它通过创新的MoE架构,让电影级视频生成变得高效可控。创作者只需简单指令,即可精准调节光影、构图与运镜效果,1080P画质下物理模拟真实自然。云端生... AI模型测评库 1年前04080
语音新标杆,开源全能王:Qwen3-ASR Flash 大模型深度评测 本文深度评测阿里通义千问开源的Qwen3-ASR Flash语音识别大模型。从多轮对话理解、意图识别、生成能力到知识库检索,全面解析其卓越的抗噪性能、52种语言支持和高达2000倍的吞吐效率。详细对比... AI模型测评库 8个月前04040
Grok 4 深度测评:xAI新一代全能模型的突破与进化 xAI最新发布的Grok 4代表了该公司在大语言模型技术上的重大飞跃,在理解能力、推理深度和多模态交互等方面实现了全面升级。作为Grok系列的最新旗舰,该模型不仅在性能上大幅提升,更在实用性和安全性... AI模型测评库 1年前04040
Qwen3 1.7B深度测评:不只是“小而美”,更是能打能扛的本地化AI主力 本文深度测评阿里开源轻量级大模型Qwen3 1.7B,从模型理解、生成能力、知识检索、智能助手、性能指标、集成兼容、安全保护、成本效益、可扩展性及本地化部署十大维度进行全方位实测。文章揭秘了这款仅17... AI模型测评库 7个月前04030
万相2.5 I2I Preview深度测评:主体一致性保持与多图融合,能否重新定义AI图像编辑? 本文深度测评阿里通义万相2.5 I2I Preview图像编辑模型。从模型理解能力、生成效果、多图融合、API性能、成本效益到部署流程进行全面评估。测评发现该模型在主体一致性保持和多意图识别方面表现惊... AI模型测评库 8个月前03970
小身材大智慧:腾讯混元Hunyuan-A13B全面测评——13B激活参数如何撬动千亿级效果? 本文全面测评了腾讯混元最新开源的Hunyuan-A13B大模型。通过对其理解能力、生成能力、性能指标及部署流程的深度剖析,揭示了这款13B激活参数的MoE模型如何以极致的性价比,在性能上比肩千亿级模型... AI模型测评库 7个月前03960
性能与价格的“双冠王”?豆包1.5 Pro 32k大模型深度测评:8毛钱就能玩转百万tokens 本文深度测评豆包1.5 Pro 32k大模型,从理解能力、生成能力、知识库检索到成本效益等十大维度进行全面剖析。结果显示,该模型在完全不依赖蒸馏技术的情况下,通过自研稀疏MoE架构实现性能飞跃,更以百... AI模型测评库 8个月前03940
Yi Large大模型深度测评:中国智造的全能型AI选手 01.AI推出的Yi Large大模型展现出卓越的中英文处理能力,32k长文本理解准确率达89%,中文意图识别准确率94%。专为中国市场优化,提供政策解读、代码生成(首运通过率100%)等本土化服务... AI模型测评库 1年前03920
OmniVinci全模态大模型深度测评:重塑多模态AI的边界 OmniVinci全模态大模型凭借创新架构,以1/6训练数据实现性能超越。在多轮对话、跨模态生成等场景表现卓越,支持三系统本地部署,为AI应用提供高效解决方案。 AI模型测评库 1年前03910
盘古NLP N2 32K大模型深度测评:企业级智能中枢的「快慢思考」革命 本文深入测评华为盘古NLP N2 32K大模型。文章严格依照模型理解、生成、知识检索、性能、安全、成本及本地化部署等维度展开,验证了其在“快慢思考融合”与“降低幻觉”方面的技术突破。结论指出,该模型虽... AI模型测评库 7个月前03880
昆仑芯上的多模明珠:百度 Qianfan VL 8B 大模型深度测评与本地化部署实战 本文深度测评百度千帆Qianfan VL 8B多模态大模型,全面解析其在理解能力、生成能力、知识检索及智能助手等十大维度的表现。文章重点展示了模型在中文场景下的卓越性能,并提供Windows、macO... AI模型测评库 8个月前03870
GLM 4.5大模型深度测评:全面解析新一代AI引擎的核心能力 在人工智能技术日新月异的今天,大型语言模型(LLM)已成为推动数字化转型的核心动力。作为国产大模型的代表之一,GLM系列持续迭代升级,最新推出的GLM 4.5版本在多个维度实现了显著突破。本文将从研... AI模型测评库 1年前03780
快手KAT-V1大模型深度测评:一款专为中文多模态优化的轻量级模型 快手近期开源的KAT-V1(Kwai Advanced Transformer),是一款面向中文多模态场景优化的轻量级大模型,旨在提升短视频、社交互动等业务场景的AI能力。 AI模型测评库 1年前03770
速度与智慧的狂想曲:xAI Grok 4 Fast系列深度测评 —— 不仅是快,更是200万Token视野下的冷静思考者 本文深度测评xAI最新Grok 4 Fast系列,全面解析其200万Token超长上下文、双模式意图识别、实时X平台数据检索等核心能力。实测显示响应速度最高提升10倍,推理成本降低60%,已集成至微软... AI模型测评库 8个月前03760
Baichuan-M3大型语言模型全方位评估报告 本文是对百川智能Baichuan-M3大模型的全面技术评估报告。报告严格遵循评估框架,从模型理解、生成能力、知识检索、智能助手、性能指标、安全保护、成本效益及部署流程等十大维度进行系统测评,为技术选型... AI模型测评库 9个月前03720
端侧AI性能标杆:谷歌Gemma 3n E2B模型深度测评 端侧AI性能标杆!本文全面测评谷歌Gemma 3n E2B模型,从多轮对话理解、代码生成能力、多模态交互到本地化部署全流程。仅需2GB内存即可运行5B参数模型,支持Windows、macOS、Linu... AI模型测评库 7个月前03660
Jamba Reasoning 3B模型全面测评:小巧而强大的边缘AI新选择 Jamba Reasoning 3B开源模型采用创新SSM-Transformer混合架构,在3B参数量下实现256K上下文长度。测评显示其在多轮对话、意图识别和代码生成方面超越同规模模型,支持本地化... AI模型测评库 1年前03630
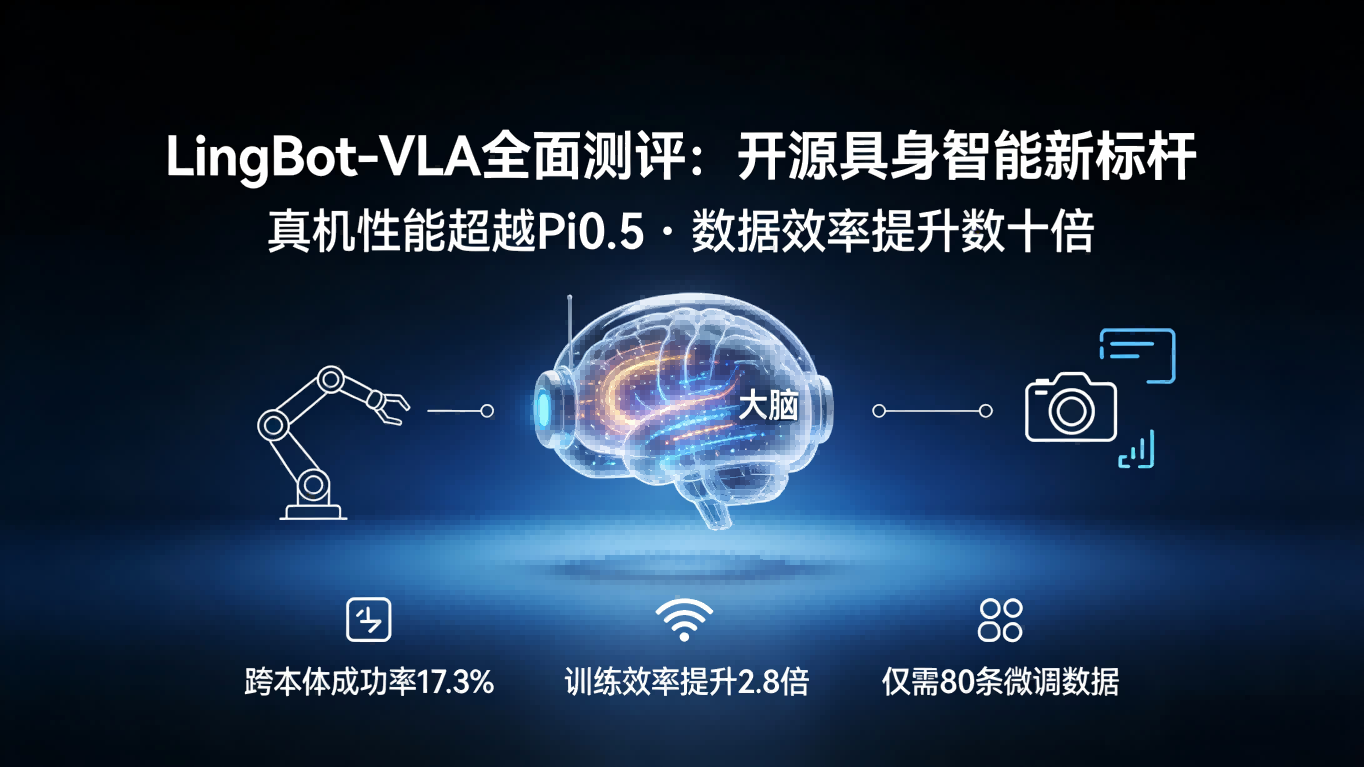
LingBot-VLA全面测评:开源具身智能新标杆,真机性能超越Pi0.5 本文是对蚂蚁灵波开源的具身智能基座模型LingBot-VLA的全面深度测评。文章从模型理解、生成能力、性能指标、安全与成本效益等十大维度进行剖析,揭示其如何通过高效的数据利用和强大的跨本体泛化能力,为... AI模型测评库 9个月前03610
多模态实力派选手:Qwen VL Max深度测评——从意图理解到本地化落地的全方位审视 本文深度测评通义千问旗舰多模态模型Qwen VL Max,从多轮对话理解、生成能力、知识检索到性能指标全面剖析。特别提供Windows、macOS、Linux三大系统本地化部署详细教程,分析成本效益与... AI模型测评库 7个月前03520
华为盘古NLP N2 128K深度测评:百亿级参数的“长文本王者”能否扛起企业级落地大旗? 本文深度测评华为盘古NLP N2 128K大模型。作为拥有128K超长上下文的“长文本王者”,文章从模型理解、生成能力、知识库检索、智能助手、性能指标、集成兼容、安全保护、成本效益、可扩展性及本地化部... AI模型测评库 7个月前03490
深度思考的暴力美学:阿里千问Qwen3-Max-Thinking全能测评报告——万亿参数下的国产模型新巅峰 本文深度测评阿里千问最新旗舰Qwen3-Max-Thinking。作为万亿参数大模型,其"测试时扩展"与"自适应工具调用"两大核心技术,让AI从被动应答进化为主动思考的智能体。文章从理解能力、生成能力... AI模型测评库 8个月前03430
Sonar大模型深度测评:新一代代码优先AI的崛起 这款由BigCode打造的AI编程助手展现出专业级实力,具备82%的代码首运通过率和96%的错误诊断准确率。支持16k超长上下文记忆,提供从代码生成到系统设计的全流程辅助。本地化部署方案既保障代码安全... AI模型测评库 1年前03430
动静皆宜,声画合一:阿里Wan2.5 I2V Preview多模态模型深度测评 深度测评阿里Wan2.5 I2V Preview模型,全球首个原生音画同步的开源图生视频模型。文章从模型理解、生成能力、音画同步质量、性能指标、集成兼容性、成本效益到本地化部署(Windows/Mac... AI模型测评库 8个月前03390
深度评测 | 国产多模态“尖子生”Hunyuan T1 Vision:它离Gemini还有多远? 本文深度测评了腾讯最新多模态大模型Hunyuan T1 Vision。从模型理解、生成能力、知识检索到性能、安全、成本及本地化部署,全方位剖析了这款“国产多模态尖子生”的真实表现。通过详实的数据与场景... AI模型测评库 7个月前03360
Minimax M1 专业级大模型深度测评:垂直领域的AI专家 在金融、法律等专业场景中,Minimax M1展现出超越通用模型的领域理解深度,其结构化信息处理能力达到商用级水平,但在跨领域泛化能力上仍需提升。 AI模型测评库 1年前03340
小身材蕴含大智慧:SAIL-VL2多模态大模型全面测评 SAIL-VL2是抖音团队推出的新一代多模态大模型,仅2B参数却在多项基准测试中媲美更大规模模型。本文全面测评其在对话理解、视觉推理、知识检索等方面的卓越表现,详细解析本地部署流程,展现这款“小而强... AI模型测评库 1年前03330