近日,普林斯顿大学 AI Lab 团队正式推出了一项全新的空间智能基准测试 —— SSoN。该测试旨在剥离动态交互与动作控制的干扰,专门检验人工智能在静态跨视角下的三维空间理解能力。测试结果显示,在“四选一挑异常”的室内空间考题面前,人类的准确率高达83.3%,而受测的主流视觉语言模型最高仅有39.7%,甚至多数模型的表现低于四选一的随机基线,暴露出当前 AI 在空间几何推理上的核心短板。
SSoN 基准测试的核心任务逻辑非常直观:通过向受测模型提供四张静态的室内场景图像,要求模型准确找出其中不属于同一场景的那张“异常图”。
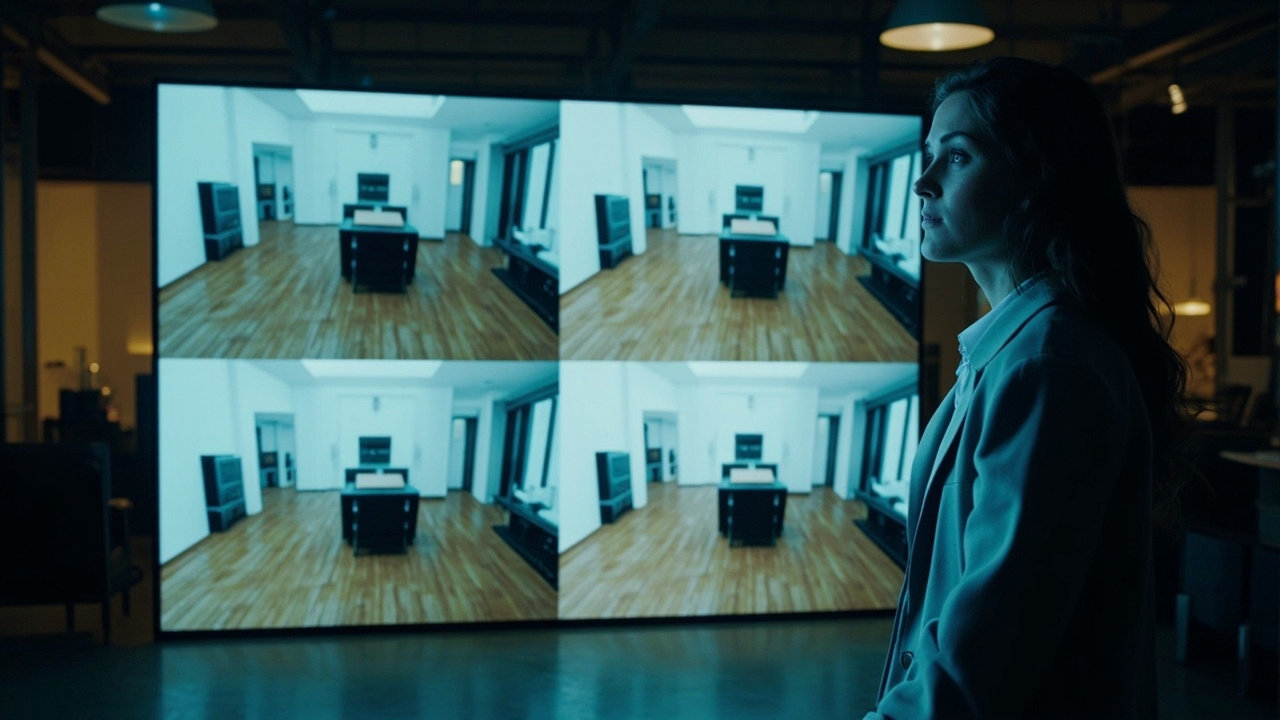
通过这种方式,测试能够直接检验 AI 是否具备真正的跨视角三维空间整合能力。然而,测试结果显示出巨大的鸿沟:人类能够凭借直觉和生活经验轻松识别出空间逻辑上的不协调,而当前的视觉语言模型在面对此类测试时显得捉襟见肘。
三大核心痛点:几何推理短板明显,解释有效性堪忧
深入分析模型的答题表现,普林斯顿研究团队发现当前大模型在空间智能上暴露出三大显著痛点:
移动与旋转推理成最大短板: 在各类几何推理题型中,特别是涉及物体相对位置移动、视角旋转等空间变换的场景下,模型的错误率居高不下,短板极为突出。
知其然而不知其所以然: 在模型少数选对答案的结果中,有近三成的推理解释在逻辑上根本不成立,属于典型的“蒙对答案却说不清理由”。
整体表现不及随机盲猜: 多数受测模型的综合准确率甚至低于四选一的随机基线,说明它们尚未真正建立起稳定的三维空间直觉。
后续干预实验:定向微调与相机参数成破局关键
为了探究如何帮助 AI 跨越这道技术鸿沟,研究团队随后开展了一系列干预实验:
提示引导与三维重建: 实验表明,通过文字提示引导或引入传统的三维重建流程,只能为模型的成绩带来小幅度的提升。
提供真实相机参数: 当直接为模型提供真实的相机参数时,其表现得到了大幅度改善,但即便如此,依然未能实现半数以上题目的可靠答对。
定向监督微调: 令人鼓舞的是,针对该任务开展定向监督微调,可以让模型在未见过的全新房间测试题上,准确率实现近乎翻倍的飞跃。
这一结果充分验证了,大模型的空间一致性判断能力并非不可攻克,完全可以通过有针对性的定向监督训练实现迁移与提升。SSoN 基准的推出,成功剥离了多余的干扰因素,直指当前 AI 在三维空间跨视角整合上的核心缺口,也为全球研究人员后续迭代空间智能技术指明了清晰的前进方向。
微软Windows设计主管Marcus Ash披露,Win11 26H2原生测速工具源于用户“不想离开系统就能测网”的反馈。最初由一名员工业余时间借AI代理辅助开发,一天出原型。早前与Ookla合作版本仅是Bing网页包装,上月真正贴合Windows风格的原生工具才上线,体现“人定方向、AI跑腿”。
11月3日,百度在深圳AI Day·Apollo专场首次披露面向物理AI的世界模型Apollo World。百度智能驾驶首席架构师王亮表示,约百辆萝卜快跑无人车已搭载新一代端到端架构运营,累计全无人运营安全里程接近百万公里。新架构从驾驶数据直接学习驾驶策略,预测转向、油门、刹车等控制信号。为验证模型安全性,百度推出Apollo。
Anthropic正开发开源验证系统FlashProve,旨在解决用户收到的AI回答是否真由所宣称模型生成的问题。公司周二博客称,其“可证明推理”将用密码学为每条输出提供数学保证,确认出自指定模型,类似加密邮件签名验证发件人。该系统可防止甲模型伪装成乙模型,堵住成本作弊暗门,并揭穿“注水”成绩单,直击行业长期潜规则。
11月4日,蚂蚁灵光升级,新增播客订阅、夸克网盘、哈啰打车、麦当劳、微信读书等连接器,覆盖信息管理、内容订阅、运动阅读和生活消费等场景。此前已接入支付宝、网易邮箱、飞书等,至此开放生态共打通40项外部连接器。文章指出,随着AI助手连接更多外部服务,其价值正体现在跨工具、跨场景的任务管理能力上。
据爆料,字节跳动出台新规,限制员工在内部自费使用Claude、Codex等第三方个人AI账号。本月起,全公司所有L4级代码仓库和飞书文档将封禁外部AI访问,员工个人采购账号无法在这些核心区域使用。此举出于核心资产安全与分级管控考虑,L4对应原3-1级别。

关注 “悠AI” 更多干货技巧行业动态
相关文章
